

Nel precedente articolo, ChatBot della PA, affrontavo il tema dell'intelligenza artificiale nel rapporto fra amministrazione e cittadino, sostenendo la necessità di rendere le informazioni pubbliche accessibili attraverso fonti autorevoli, strutturate e interrogabili, anziché moltiplicare gli assistenti conversazionali sui portali istituzionali.
La stessa impostazione può essere estesa ai processi interni degli enti locali, dove la crescente disponibilità di sistemi informativi non ha eliminato una quantità significativa di attività manuali dedicate all'interpretazione, alla classificazione e al trasferimento delle informazioni. Un Comune può disporre di un protocollo informatico, di un sistema documentale, di applicativi tributari, finanziari e demografici, continuando a impiegare personale per collegare dati e documenti che appartengono allo stesso procedimento ma risiedono in sistemi differenti.
Questa condizione dipende in parte dall'interoperabilità ancora incompleta degli applicativi e in parte dalla natura delle informazioni trattate. Le integrazioni tradizionali funzionano efficacemente quando i dati possiedono strutture note e le operazioni possono essere descritte attraverso regole deterministiche. Diventano invece più complesse quando occorre interpretare comunicazioni, relazioni, istanze e documenti prodotti in linguaggio naturale.
I modelli linguistici e le tecnologie di elaborazione documentale consentono oggi di affrontare una parte di queste attività senza sviluppare un modello specifico per ogni amministrazione. L'introduzione dell'intelligenza artificiale può quindi essere progettata come un'evoluzione dell'architettura informativa dell'ente, nella quale capacità di interpretazione e classificazione vengono rese disponibili ai sistemi esistenti attraverso servizi condivisi.
Perché questo approccio sia sostenibile, occorre però separare le capacità probabilistiche dei modelli dalle regole che governano i procedimenti, le autorizzazioni e le operazioni applicative. La costruzione di tale separazione costituisce il problema tecnico e amministrativo sul quale concentrerò questo articolo.
Le opportunità di automazione negli enti locali
Le attività ripetitive presenti negli uffici comunali offrono numerose possibilità di applicazione, soprattutto quando i sistemi informativi possiedono già interfacce di integrazione o possono essere adeguati per renderle disponibili.
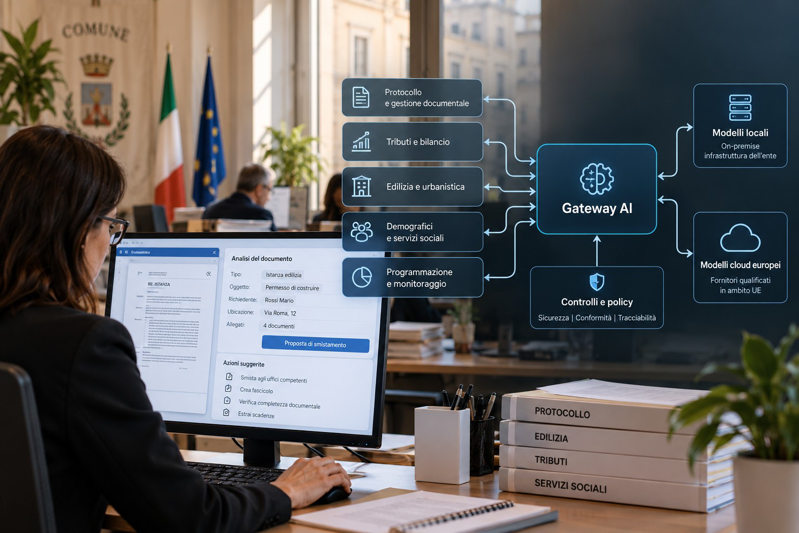
- Gestione documentale e attività amministrative. Classificazione delle comunicazioni, proposta di smistamento agli uffici, estrazione dei dati dagli allegati, ricerca di documenti correlati, individuazione delle scadenze, confronto fra versioni di atti, predisposizione di bozze e creazione assistita delle attività conseguenti.
- Tributi, bilancio e contratti. Classificazione delle istanze, riconoscimento di informazioni catastali e tributarie, confronto documentale, verifica preliminare della completezza delle pratiche, associazione dei giustificativi ai contratti, estrazione di obblighi e scadenze e consultazione assistita di regolamenti e capitolati.
- Edilizia, urbanistica, patrimonio e lavori pubblici. Analisi delle relazioni tecniche, controllo documentale preliminare, consultazione delle norme urbanistiche, organizzazione dei pareri, lettura dei verbali, monitoraggio dei cronoprogrammi, classificazione delle segnalazioni e collegamento delle attività manutentive agli immobili.
- Personale, servizi demografici, educativi e sociali. Ricerca nelle disposizioni operative, organizzazione delle richieste amministrative, predisposizione di comunicazioni informative, gestione documentale delle istanze, assistenza nella verifica degli allegati e aggiornamento delle attività interne, con controlli proporzionati alla sensibilità delle informazioni e agli effetti delle elaborazioni.
- Direzione, programmazione e monitoraggio. Estrazione di adempimenti da atti e documenti di finanziamento, organizzazione delle evidenze, confronto degli stati di avanzamento, preparazione di riepiloghi, individuazione delle attività ancora da completare e monitoraggio degli obblighi contrattuali e organizzativi.
Queste applicazioni condividono una caratteristica. Il modello AI interpreta informazioni, produce rappresentazioni strutturate o recupera contenuti pertinenti, mentre i sistemi amministrativi continuano a governare le operazioni che appartengono al proprio dominio.
La possibilità tecnica di automatizzare una funzione non ne determina automaticamente l'ammissibilità. Un sistema che organizza documenti presenta problematiche differenti rispetto a uno che partecipa alla valutazione di persone o alla determinazione di benefici. Inoltre, non tutte le attività ripetitive richiedono intelligenza artificiale. Quando i dati sono strutturati e le regole sono note, un'automazione tradizionale offre generalmente maggiore prevedibilità e un controllo più semplice degli errori.
L'analisi delle opportunità dovrebbe quindi concentrarsi sul contributo specifico che l'AI può apportare, evitando di sostituire con elaborazioni probabilistiche operazioni che possono essere eseguite attraverso normali regole applicative.
1. Dalla ricognizione dei processi al governo amministrativo
La progettazione dovrebbe iniziare con una ricognizione dei processi, dei sistemi e dei trattamenti informativi, coordinata nell'ambito della governance digitale dell'ente. Prima di valutare modelli e fornitori, l'amministrazione deve conoscere quali operazioni intende automatizzare, quali informazioni risultano necessarie, chi ne è responsabile e quali effetti possono derivare da un risultato errato.
Il Responsabile per la Transizione al Digitale, al quale l'articolo 17 del CAD affida la transizione dell'ente alla modalità operativa digitale, coordina la strategia tecnologica lavorando con la dirigenza, i responsabili dei sistemi informativi, i titolari delle funzioni amministrative e le figure competenti per la protezione dei dati. L'organizzazione deve mantenere distinte la responsabilità dell'infrastruttura tecnologica e quella dei procedimenti che utilizzeranno le capacità AI.
La ricognizione deve produrre un catalogo dei servizi e delle relative dipendenze, nel quale ciascuna possibile automazione sia associata a una finalità, ai sistemi coinvolti, alle categorie di informazioni trattate e al livello di autonomia richiesto. Questa analisi consente anche di individuare i servizi che possono condividere le medesime capacità tecnologiche, evitando di acquisire più soluzioni per compiti sostanzialmente equivalenti.
Il progetto dovrebbe quindi essere ricondotto alla programmazione digitale e autorizzato attraverso gli atti appropriati all'organizzazione dell'ente e alla natura dell'intervento. Quando sono necessari servizi o forniture esterne, occorre definire il percorso di acquisizione secondo il Codice dei contratti pubblici, distinguendo i requisiti funzionali dalle caratteristiche di uno specifico prodotto commerciale.
In questa fase il GDPR impone di definire le basi giuridiche dei trattamenti, verificare la necessità delle informazioni utilizzate e individuare le misure di protezione appropriate. L'eventuale valutazione d'impatto prevista dall'articolo 35 deve essere affrontata quando ricorrono i relativi presupposti, senza considerare la sola esecuzione locale del modello come una garanzia sufficiente.
Il quadro europeo richiede anche una classificazione del sistema rispetto all'AI Act. Non tutte le applicazioni AI utilizzate da un'amministrazione sono ad alto rischio, poiché tale qualificazione dipende dalla destinazione d'uso e dalle condizioni previste dal regolamento.
Il Regolamento (UE) 2026/1744, pubblicato il 24 luglio 2026 ed entrato in vigore il 27 luglio, ha modificato il calendario applicativo dell'AI Act, rinviando al 2 dicembre 2027 l'applicazione degli obblighi per i sistemi ad alto rischio dell'allegato III e al 2 agosto 2028 quella relativa ai sistemi ad alto rischio collegati ai prodotti regolati dell'allegato I. Anche gli obblighi dell'articolo 27 sulla valutazione d'impatto sui diritti fondamentali, nei casi in cui sono previsti, seguono il calendario applicabile alla relativa categoria di sistemi.
In Italia, l'articolo 14 della legge 132/2025 riconosce l'impiego dell'AI per migliorare l'efficienza amministrativa e la qualità dei servizi, mantenendone la funzione strumentale e di supporto all'attività provvedimentale, con responsabilità delle decisioni in capo alla persona. La norma richiede inoltre di assicurare la conoscibilità del funzionamento del sistema e la tracciabilità del suo utilizzo.
Le amministrazioni possono inoltre utilizzare come riferimenti metodologici i documenti AgID dedicati all'AI, distinguendo però il loro stato di adozione. Le linee guida sull'adozione, pubblicate con la Determinazione 17/2025 e sottoposte a consultazione dal 18 febbraio al 20 marzo 2025, risultano ancora in fase di completamento dell'iter. Le linee guida sullo sviluppo e sul procurement, oggetto della Determinazione 43/2026, sono state sottoposte a consultazione dal 12 marzo all'11 aprile 2026 e non risultano ancora definitivamente adottate.
Al termine della fase amministrativa l'ente dovrebbe disporre di un perimetro formalmente definito, con finalità, responsabilità, trattamenti consentiti, limiti operativi e criteri di valutazione. Questi elementi costituiscono requisiti per l'architettura e non semplici adempimenti documentali da completare dopo la realizzazione del software.
2. Costruire l'architettura sulle API e sull'interoperabilità
Un sistema AI destinato a operare trasversalmente ai servizi comunali deve integrarsi con gli applicativi esistenti senza acquisirne le responsabilità.
Il presupposto è la disponibilità di interfacce applicative attraverso le quali recuperare informazioni e richiedere operazioni in maniera autenticata e verificabile. L'accesso diretto ai database dovrebbe essere evitato quando esistono API di dominio, perché aggirare la logica dei gestionali significa rinunciare ai controlli, alle regole e alle garanzie implementate dai sistemi proprietari delle informazioni.
Per la Pubblica Amministrazione italiana questo percorso deve essere coerente con il Modello di Interoperabilità, ModI, e con le linee guida AgID sull'interoperabilità tecnica e sulla sicurezza delle API. Il modello definisce principi e strumenti per realizzare interfacce documentate, versionate e protette, favorendo l'integrazione fra sistemi senza imporre la dipendenza dalle loro implementazioni interne.
Le API costituiscono il confine attraverso il quale un sistema espone funzionalità e dati in condizioni controllate. Un gateway AI non dovrebbe quindi sviluppare integrazioni arbitrarie con gli archivi applicativi, ma utilizzare servizi che rispettino contratti espliciti, prevedendo autenticazione, autorizzazione, tracciabilità e gestione degli errori.
La Piattaforma Digitale Nazionale Dati può assumere un ruolo importante quando l'automazione richiede informazioni rese disponibili da altre amministrazioni attraverso e-service. La PDND abilita le relazioni di interoperabilità fra soggetti aderenti, secondo meccanismi di identificazione, autorizzazione e fruizione delle API.
È però necessario distinguere le integrazioni interne dalle interazioni fra amministrazioni. La PDND non costituisce il canale obbligatorio attraverso il quale debbano transitare tutte le chiamate fra gli applicativi di un Comune e il suo gateway AI. Quest'ultimo può utilizzare API interne per i sistemi dell'ente e, quando necessario e autorizzato, accedere a e-service esterni attraverso le modalità previste dall'ecosistema di interoperabilità.
La presenza di un'API, anche quando tecnicamente accessibile, non attribuisce automaticamente il diritto di utilizzarne le informazioni per qualsiasi finalità. Le autorizzazioni alla fruizione, la base giuridica del trattamento e i limiti d'impiego devono essere verificati nel contesto dell'applicazione.
Nella progettazione conviene adottare contratti applicativi indipendenti dai singoli modelli linguistici, descritti mediante standard come OpenAPI e schemi formalizzati dei dati. Le operazioni dovrebbero essere organizzate per capacità, distinguendo la consultazione dalle modifiche persistenti.
Per i flussi asincroni, nei quali un'elaborazione può richiedere tempi non compatibili con una chiamata HTTP sincrona, possono essere impiegati eventi applicativi e code persistenti. Il sistema deve mantenere identificativi di correlazione che permettano di ricostruire il rapporto fra richiesta, elaborazione AI e operazione successiva.
Questa struttura consente di utilizzare l'AI come componente dell'architettura applicativa, mantenendo i dati nei sistemi competenti e riducendo il rischio di creare nuovi archivi paralleli non governati.
3. Il gateway AI come componente del sistema informativo
Collegare ogni applicativo direttamente a un provider AI rappresenta una soluzione semplice da realizzare, ma difficilmente sostenibile quando il numero dei servizi aumenta. Ogni integrazione finisce per incorporare credenziali, formati specifici, regole sui dati, configurazioni e modalità di gestione degli errori, rendendo complesso applicare politiche uniformi e sostituire le tecnologie utilizzate.
Un AI gateway condiviso permette di separare queste responsabilità attraverso un livello di accesso comune ai modelli e alle capacità di elaborazione.
L'architettura deve distinguere il piano di controllo, nel quale l'amministrazione definisce identità, autorizzazioni, policy e modelli ammessi, dal piano di elaborazione, nel quale le richieste vengono effettivamente eseguite. Questa distinzione permette di modificare le destinazioni tecnologiche senza riscrivere le regole che determinano se un trattamento sia consentito.
Il gateway deve ricevere richieste provenienti da applicazioni autenticate e identificarne il contesto operativo. Un token applicativo, ad esempio ottenuto mediante meccanismi basati su OAuth 2.0 e verificato rispetto a destinatario, ambiti autorizzativi e validità, può consentire al servizio di conoscere l'identità del chiamante. Quando l'applicazione opera per conto di una persona, anche le autorizzazioni effettive dell'utente devono contribuire alla valutazione.
L'accesso alle capacità AI dovrebbe essere governato attraverso regole formalizzate, non mediante istruzioni affidate esclusivamente al modello linguistico.
Una possibile architettura prevede un Policy Decision Point, responsabile di valutare le condizioni della richiesta, e un Policy Enforcement Point, che applica concretamente la decisione impedendo l'invocazione di modelli o strumenti non autorizzati.
La decisione considera la finalità del servizio, l'origine e la classificazione delle informazioni, i permessi disponibili, le caratteristiche dei provider e le operazioni richieste. La classificazione dichiarata dal client non deve essere accettata senza controlli quando il sistema dispone di informazioni più affidabili sulla natura dei dati.
Soltanto dopo questa verifica il gateway può scegliere il modello da utilizzare, eventualmente ottimizzando la selezione sulla base di qualità misurata, latenza, disponibilità e costo.
Il principio fondamentale è che l'ottimizzazione del modello avviene all'interno dell'insieme delle destinazioni consentite, e non può modificare le condizioni che rendono ammissibile il trattamento.
Un modello cloud più potente non deve diventare automaticamente il sostituto di un modello locale indisponibile, quando le informazioni non possono essere trasmesse al provider esterno. In queste circostanze il sistema deve interrompere l'elaborazione o utilizzare un percorso alternativo autorizzato.
Il gateway potrebbe esporre servizi di classificazione, estrazione strutturata, generazione vincolata, ricerca documentale e utilizzo controllato degli strumenti, mantenendo un catalogo di modelli e provider che riporti le caratteristiche tecniche e contrattuali di ciascuna destinazione.
Anche PA Router, progetto che sto sviluppando per governare attraverso policy l'accesso a modelli locali, servizi cloud e strumenti agentici, si colloca in questa prospettiva e potrebbe evolvere verso un gateway condiviso utilizzabile dagli applicativi degli enti.
Il gateway non deve però sostituire il motore che governa il processo amministrativo. Le transizioni, gli interventi umani, le operazioni sui gestionali e le condizioni di completamento restano responsabilità degli applicativi di dominio o dei sistemi di workflow.
Per ogni richiesta AI il gateway identifica quindi il servizio, verifica le autorizzazioni, applica le policy sui dati, sceglie una destinazione ammissibile, esegue l'elaborazione e valida l'output. Solo successivamente il sistema applicativo decide se utilizzare il risultato per proseguire il proprio processo.
Questa separazione è essenziale anche per la continuità operativa. Un'interruzione del gateway non dovrebbe impedire il funzionamento dei procedimenti che possono essere gestiti attraverso i normali sistemi amministrativi.
4. Modelli locali, cloud europeo e sovranità dei dati
La scelta dei modelli deve essere subordinata alle caratteristiche delle attività e dei dati, evitando di assumere che un unico modello generativo sia adeguato a tutte le esigenze dell'ente.
Per classificazioni circoscritte, estrazioni documentali e interpretazioni di contenuti brevi possono essere valutati modelli di dimensioni contenute, eseguiti mediante infrastrutture locali o servizi dedicati. Tecnologie come Ollama e vLLM permettono di realizzare ambienti di inferenza accessibili attraverso API, mentre famiglie di modelli con pesi disponibili, come Qwen e Mistral, consentono di confrontare differenti soluzioni senza dipendere necessariamente da un servizio proprietario.
La scelta deve dipendere dai risultati misurati, non dal numero di parametri. Per alcuni compiti possono risultare più appropriati classificatori tradizionali o modelli di embedding, mentre elaborazioni linguisticamente complesse possono richiedere capacità generative maggiori.
Un ambiente locale offre un controllo diretto sull'infrastruttura di inferenza, ma richiede risorse hardware, manutenzione, aggiornamento dei modelli e protezione delle interfacce. L'esecuzione su un server dell'ente non esclude automaticamente la presenza di log, memorie persistenti o collegamenti esterni che possano determinare ulteriori trattamenti.
Il cloud può invece consentire l'accesso a modelli più potenti e a capacità elastiche senza mantenere direttamente l'intera infrastruttura computazionale. Per un'amministrazione pubblica, tuttavia, la presenza di una regione europea non dimostra da sola che il servizio garantisca sovranità dei dati.
È necessario verificare la localizzazione effettiva delle elaborazioni, il trattamento dei log e dei metadati, gli accessi dei subfornitori, i tempi di conservazione, le condizioni di cancellazione e gli eventuali trasferimenti internazionali. Per gli enti pubblici italiani occorre inoltre considerare la classificazione dei dati e dei servizi e la disciplina ACN relativa alle infrastrutture e ai servizi cloud.
La sovranità comprende anche la capacità di sostituire un fornitore, esportare informazioni e configurazioni, mantenere il controllo sulle chiavi e impedire che i dati siano utilizzati per finalità non autorizzate.
Un'architettura ibrida può rispondere a esigenze differenti, destinando alcune elaborazioni a modelli locali e altre a servizi cloud ammessi dalle policy. Il gateway rende operativa tale distinzione senza trasferire alle singole applicazioni la responsabilità di decidere autonomamente dove inviare le informazioni.
Un ulteriore problema riguarda la costruzione delle basi informative utilizzate dai modelli. Le architetture RAG permettono di recuperare contenuti pertinenti da archivi autorizzati, riducendo la dipendenza dalla conoscenza incorporata nel modello e consentendo di ricondurre le risposte alle fonti.
Il recupero deve però rispettare le autorizzazioni dei documenti originali e le loro versioni. L'indicizzazione non deve trasformare informazioni riservate in un patrimonio indiscriminatamente consultabile dagli applicativi che utilizzano il gateway.
Anche gli embedding richiedono attenzione, perché una trasformazione vettoriale non comporta automaticamente l'anonimizzazione delle informazioni di origine. Occorre valutare la possibilità di collegare le rappresentazioni ai documenti o di ricavare informazioni personali dal sistema di recupero.
Il tema va distinto da quello dell'anonimato dei modelli addestrati su dati personali, affrontato dall'European Data Protection Board nell'Opinion 28/2024. L'EDPB chiarisce che non si può presumere l'anonimato di un modello e che la valutazione richiede di considerare concretamente la possibilità di ottenere informazioni personali attraverso il modello stesso. Il principio metodologico è pertinente anche alla progettazione delle basi informative, pur trattandosi di componenti tecnicamente differenti.
5. Orchestrazione, sicurezza e responsabilità delle operazioni
L'integrazione dei modelli con i processi amministrativi introduce un problema distinto da quello dell'accesso ai dati. Un modello può produrre informazioni utili, ma il suo output rimane il risultato di un'elaborazione probabilistica e non può essere equiparato a una transazione applicativa validata.
Le applicazioni dovrebbero richiedere risultati attraverso contratti strutturati, utilizzando quando possibile schemi formali e vincoli sui valori ammessi. La generazione vincolata può migliorare il rispetto del formato richiesto, ma non garantisce la correttezza sostanziale delle informazioni prodotte.
Il sistema destinatario deve quindi verificare i riferimenti, la coerenza dei dati, le regole di dominio e le autorizzazioni necessarie prima di procedere. Una classificazione formalmente valida può essere semanticamente errata, così come un'informazione estratta correttamente può risultare non pertinente al procedimento.
Le operazioni che modificano lo stato dei sistemi richiedono controlli ulteriori. Un workflow affidabile deve gestire identificativi univoci, esecuzioni ripetute, interruzioni, errori dei connettori e possibili duplicazioni. Quando le attività coinvolgono più sistemi possono essere necessarie code persistenti, meccanismi di idempotenza e procedure di compensazione per le operazioni effettivamente reversibili.
L'introduzione degli agenti aumenta la complessità, perché un modello può scegliere di invocare strumenti per acquisire informazioni o richiedere azioni. Protocolli come MCP possono facilitare l'esposizione delle funzionalità, ma non attribuiscono al modello il diritto di utilizzarle.
Le autorizzazioni devono essere verificate da componenti indipendenti, secondo il principio del minimo privilegio. Un servizio autorizzato a consultare documenti non dovrebbe disporre delle credenziali necessarie a modificarli, e un modello incaricato di produrre classificazioni non deve poter eseguire operazioni arbitrarie sui sistemi informativi.
Una particolare attenzione deve essere dedicata agli attacchi di prompt injection, nei quali informazioni esterne contengono istruzioni finalizzate ad alterare il comportamento del modello. Documenti, messaggi e contenuti recuperati devono essere trattati come dati non attendibili dal punto di vista delle istruzioni, indipendentemente dalla loro apparente autorevolezza.
La protezione richiede separazione fra istruzioni e contenuti, limitazione degli strumenti disponibili e verifica delle azioni attraverso controlli esterni al modello. Non è sufficiente inserire nel prompt un divieto di eseguire istruzioni malevole.
Sul piano giuridico occorre considerare anche l'articolo 22 del GDPR, relativo alle decisioni basate unicamente su trattamenti automatizzati che producono effetti giuridici o incidono in modo analogamente significativo sulle persone. La disposizione prevede eccezioni e condizioni specifiche, ma impedisce di considerare liberamente automatizzabili le decisioni individuali soltanto perché il sistema è tecnicamente in grado di produrle.
L'eventuale intervento umano deve avere contenuto sostanziale. Una conferma meramente formale, effettuata senza strumenti per comprendere e contestare il risultato, non rappresenta necessariamente un controllo effettivo.
Occorre pertanto progettare il livello di supervisione in funzione degli effetti dell'operazione, della sua reversibilità e della capacità di rilevare l'errore. Le attività informative e le elaborazioni a basso impatto possono ammettere modalità operative più autonome, mentre le decisioni con conseguenze rilevanti richiedono le garanzie previste dal quadro normativo e dall'organizzazione amministrativa.
6. Collaudare scientificamente la piattaforma e governarne il ciclo di vita
L'adozione di una piattaforma AI condivisa richiede un sistema di valutazione che distingua la qualità dei modelli dall'affidabilità complessiva dell'architettura.
Un modello può classificare correttamente un documento e, nello stesso tempo, essere utilizzato da un sistema che applica autorizzazioni errate o gestisce in maniera inadeguata le interruzioni. La valutazione deve quindi considerare sia le capacità linguistiche sia il comportamento dell'infrastruttura che le rende disponibili.
Per ogni capacità devono essere definiti dataset rappresentativi, risultati di riferimento e metriche stabilite prima della valutazione. I classificatori possono essere confrontati mediante precisione, recall, misure F1 e matrici di confusione, mentre le elaborazioni documentali richiedono misure di correttezza dei campi estratti, completezza e fedeltà alle fonti.
La capacità di riconoscere condizioni di incertezza assume un ruolo fondamentale. Un sistema che si astiene quando non dispone di informazioni sufficienti può risultare più affidabile di uno che produce sempre un risultato.
Non utilizzerei automaticamente il livello di confidence dichiarato dal modello come criterio per autorizzare operazioni. Questo valore non rappresenta necessariamente una probabilità calibrata di correttezza. La sua affidabilità deve essere verificata attraverso metodi empirici, distinguendo il comportamento sulle diverse categorie di richieste.
Questo approccio è coerente con il NIST AI Risk Management Framework, che organizza la gestione del rischio lungo l'intero ciclo di vita del sistema.
La validazione dovrebbe utilizzare dati separati da quelli impiegati per configurare o ottimizzare i modelli, evitando che modifiche successive ai prompt producano un adattamento artificiale al campione di test.
Accanto alle prestazioni funzionali devono essere misurati latenza, capacità di elaborazione, disponibilità, consumo di risorse e costo per operazione. Per i sistemi locali occorre valutare anche il comportamento con richieste concorrenti, mentre per i servizi cloud devono essere controllati i limiti contrattuali e i costi variabili.
Il collaudo delle policy richiede prove specifiche, destinate a dimostrare che il gateway blocchi effettivamente le destinazioni non autorizzate, che le credenziali non consentano operazioni estranee al servizio e che eventuali indisponibilità non provochino trasferimenti di dati incompatibili con le regole.
Una fase di shadow mode, nella quale le elaborazioni AI vengono eseguite parallelamente ai processi ordinari senza modificarne lo stato, permette di confrontare i risultati con le attività degli operatori e osservare il comportamento in condizioni realistiche.
Il passaggio all'esercizio dovrebbe essere autorizzato sulla base di evidenze documentate, comprendenti risultati dei test, limiti conosciuti, requisiti di sicurezza, procedure di gestione degli errori e condizioni per il ripristino delle modalità operative precedenti.
La manutenzione richiede inoltre il versionamento dei modelli, delle configurazioni di inferenza, dei prompt, delle policy e delle fonti informative. Un aggiornamento del modello può modificare il comportamento del sistema anche quando le API rimangono invariate, rendendo necessari test di regressione prima del rilascio.
Dal punto di vista organizzativo, l'ente deve individuare chi amministra le policy, chi autorizza nuovi servizi, chi interviene sugli incidenti e chi verifica periodicamente i risultati. Il monitoraggio deve produrre informazioni sufficienti a ricostruire il comportamento tecnico senza determinare una conservazione indiscriminata dei contenuti elaborati.
Anche il costo va considerato lungo l'intero ciclo di vita. Hardware, servizi cloud, integrazioni, manutenzione, aggiornamenti, verifiche di sicurezza e supervisione concorrono al costo complessivo dell'automazione. Un modello locale con licenza d'uso gratuita può risultare oneroso da mantenere, mentre un servizio cloud apparentemente conveniente può diventare economicamente sfavorevole con l'aumentare del volume delle elaborazioni.
La valutazione del beneficio dovrebbe quindi confrontare il costo complessivo del processo precedente con quello del processo modificato, includendo errori, correzioni e attività di controllo. Il consumo di token o il numero di richieste elaborate descrivono il funzionamento dell'infrastruttura, ma non dimostrano da soli un miglioramento amministrativo.
7. Dalla piattaforma condivisa alla capacità organizzativa dell'ente
Una volta verificati i componenti infrastrutturali, l'amministrazione può introdurre progressivamente nuove capacità nei propri sistemi informativi, mantenendo un percorso di autorizzazione e valutazione proporzionato alla natura delle attività.
L'esistenza del gateway riduce la necessità di realizzare nuove integrazioni con ogni provider, ma non elimina il lavoro progettuale sui singoli processi. Ogni nuova funzione deve essere associata a una finalità autorizzata, a fonti informative attendibili, a regole di esecuzione e a criteri di misurazione del risultato.
Questa impostazione può essere particolarmente interessante per le amministrazioni che condividono infrastrutture o servizi informatici. Un gateway utilizzato da più enti può consentire economie di gestione e concentrazione delle competenze, purché l'architettura garantisca la separazione delle informazioni, delle identità e delle responsabilità dei differenti soggetti.
La condivisione dell'infrastruttura non deve essere confusa con la condivisione indiscriminata dei dati. I meccanismi di autenticazione e autorizzazione devono conservare il contesto dell'amministrazione richiedente, impedendo che un servizio possa accedere a risorse appartenenti a un altro ente in assenza dei necessari presupposti.
Per i piccoli Comuni, che difficilmente dispongono di personale specializzato nella gestione di più modelli e provider, la disponibilità di componenti condivisi potrebbe rappresentare una condizione importante per introdurre l'AI senza moltiplicare gli oneri tecnici.
La sostenibilità di questa evoluzione dipenderà tuttavia dalla disponibilità di competenze organizzative, dalla qualità delle interfacce dei gestionali e dalla capacità di mantenere aggiornate le policy. Nessun gateway può risolvere autonomamente l'assenza di regole amministrative formalizzate o l'impossibilità di accedere in maniera controllata alle informazioni necessarie.
Conclusioni
Nel precedente articolo proponevo di rendere le informazioni della Pubblica Amministrazione disponibili agli assistenti digitali attraverso fonti ufficiali e interrogabili, superando la frammentazione prodotta dalla moltiplicazione dei chatbot istituzionali.
Applicare lo stesso principio ai processi interni significa costruire una capacità comune di interpretazione e automazione, utilizzabile dai diversi sistemi dell'ente senza vincolarli a un unico modello linguistico o fornitore.
L'infrastruttura condivisa costituisce soltanto una parte della soluzione. Per ottenere risultati verificabili, l'amministrazione deve conoscere i propri processi, disporre di interfacce interoperabili, definire responsabilità e autorizzazioni, governare la circolazione delle informazioni e misurare gli effetti delle automazioni.
La qualità dell'introduzione dell'AI negli enti locali dipenderà dalla capacità di integrare questi elementi in un'architettura coerente, nella quale la tecnologia possa evolvere senza compromettere le garanzie amministrative.
Il chatbot rivolto al cittadino rimane una possibile interfaccia di questo ecosistema. Il contributo più significativo dell'intelligenza artificiale potrebbe però svilupparsi all'interno degli uffici, dove l'automazione delle attività ripetitive può ridurre il lavoro necessario a organizzare le informazioni e restituire tempo alle funzioni che richiedono competenza, valutazione e responsabilità.
Riferimenti normativi e tecnici
Regolamento (UE) 2024/1689, AI Act e Regolamento (UE) 2026/1744, Digital Omnibus.
Regolamento (UE) 2016/679, GDPR, con particolare riferimento agli articoli 22 e 35.
Legge 23 settembre 2025, n. 132, articolo 14.
AgID, documentazione sull'intelligenza artificiale nella PA, comprese le Determinazioni 17/2025 e 43/2026 e i relativi documenti in iter di adozione.
AgID, Modello di Interoperabilità.
European Data Protection Board, Opinion 28/2024.