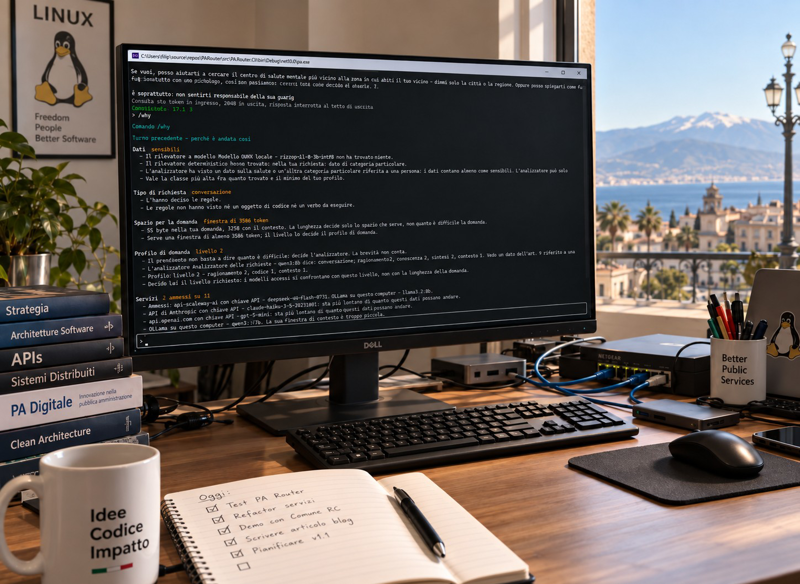
L'evoluzione dell'ecosistema AI ha trasformato radicalmente il nostro modo di lavorare. Fino a poco tempo fa, l'interazione era lineare: si apriva un singolo assistente e gli si affidava ogni richiesta. Oggi, specialmente per chi opera in ambito tecnologico, la normalità è utilizzare quotidianamente un mix di modelli locali, servizi cloud avanzati e agenti autonomi (come Codex o Claude Code) capaci di leggere file system, modificare codice ed eseguire comandi.
Con questa frammentazione, la decisione su quale strumento utilizzare è diventata complessa. La scelta del modello è soltanto una parte del problema. Una richiesta può essere semplice ma contenere informazioni riservate; un’attività complessa può richiedere la lettura di codice proprietario. Capacità del modello, destinazione dei dati e poteri del programma chiamato devono essere considerati insieme, mantenendo però distinte le rispettive decisioni.
È per rispondere a questa esigenza architetturale che sto sviluppando PA Router. Il primo ambiente di utilizzo è quello dello sviluppatore, sulla propria macchina, attraverso il terminale (CLI/REPL).
L'acronimo sta per Policy Aware, ma porta con sé un secondo significato, per me altrettanto cruciale: Pubblica Amministrazione. Chi si trova a gestire l'IT e la transizione al digitale in contesti strutturati sa bene che la conformità e la sicurezza del dato non sono "funzionalità aggiuntive". PA Router nasce come livello di controllo da anteporre agli strumenti: non per sostituirli, ma per stabilire il perimetro di ciò che è ammissibile in base a regole ferree, prima ancora di valutarne le performance.
Il Perimetro Prima dell'Ottimizzazione
Il model routing viene spesso affrontato come un problema di ottimizzazione: scegliere il servizio che offre il compromesso migliore fra qualità, costo e latenza. Sistemi eccellenti come RouteLLM rappresentano bene questa impostazione.
PA Router introduce una decisione precedente, invertendo la logica. La policy determina l’insieme dei target ammissibili; il routing sceglie all’interno di quell’insieme. Questa separazione è cablata nel codice: il modulo di routing riceve soltanto candidati già ammessi. Non può trasformare un diniego in un punteggio basso e poi compensarlo perché un modello cloud risulta molto più intelligente o economico. Prima della selezione vengono controllati disponibilità, capacità richieste, classe dei dati, destinazione consentita, finestra di contesto e limiti di spesa. Un percorso vietato resta escluso.
Privacy Strutturale e Classificazione Locale
La difficoltà tecnica di un task e la sensibilità dei dati sono grandezze indipendenti. Affidarsi esclusivamente all'ottimizzazione per decidere il routing significa affrontare il problema nell'ordine sbagliato.
In PA Router, la richiesta e il contesto vengono analizzati localmente prima dell'invio. Il sistema utilizza rilevatori deterministici per contatti, codici fiscali e credenziali, affiancati da un modello ONNX opzionale per riconoscere entità (nomi, indirizzi) e un rilevatore a termini per le categorie particolari (es. salute).
I dati vengono etichettati operativamente in classi: public, internal, personal, sensitive, secret e unknown. La destinazione è governata da zone di fiducia ben delimitate: stessa macchina (LAN), infrastruttura propria nell’Unione Europea (private_eu), fornitori con accordo di trattamento (third_party_dpa) e terzi generici.
Il router evita equivalenze improprie: un accordo di trattamento (DPA) non dimostra automaticamente che l’elaborazione avvenga nell’UE. PA Router applica vincoli tecnici configurati e ne rende verificabili le decisioni, senza pretendere di sostituirsi alla valutazione giuridica di conformità al GDPR.
L'incertezza fa parte del modello logico: quando un rilevatore non conclude l'analisi, viene concessa una sola ripetizione. Se l’incompletezza persiste, lo stato diventa unknown e il turno può essere negato. L’assenza di una classificazione riuscita non viene mai interpretata come assenza di rischio.
Modelli, Programmi e l'Ambiente di Esecuzione
Da un punto di vista architetturale, PA Router è un monolite modulare. CLI, interfaccia testuale, worker e API condividono lo stesso motore condiviso. Lo stato, la memoria e la cronologia sono conservati localmente in un database SQLite embedded (con vettori cifrati e un indice lessicale in RAM), senza appoggiarsi a database server esterni.
Il sistema dispone di adapter per Ollama, servizi OpenAI-compatible, Anthropic, e interfacce verso CLI agentiche come Codex, Claude Code e OpenCode. Proprio sugli agenti si gioca una partita fondamentale. Un agente richiede un'attenzione diversa rispetto a una semplice chat API: può leggere il workspace ed eseguire comandi. PA Router lo tratta come un programma da supervisionare rigorosamente. L'avvio degli agenti avviene in un ambiente controllato (tramite Job Object/cgroup, senza shell intermediarie), e le capacità concesse derivano dal profilo e dal recinto (fence) della sessione.
In questa architettura ibrida, la continuità operativa (handover) passa attraverso le sessioni del router. Un passaggio di consegne verso un altro servizio crea una nuova sessione e sottopone nuovamente il contesto ai controlli di privacy, garantendo sicurezza anche quando si passa da un LLM locale a un agente cloud.
Dove si colloca rispetto a ciò che esiste
Non sarebbe corretto presentare l'inserimento di privacy e policy nel routing come un’invenzione di PA Router. OpenRouter applica già restrizioni sui provider; LiteLLM agisce come un eccellente gateway gestendo guardrail pre-chiamata; vLLM Semantic Router include rilevamenti locali di PII per instradare o bloccare il traffico.
Tuttavia, questi strumenti nascono prevalentemente come infrastrutture di serving tra un'applicazione e i backend. Anche in scenari agentici, demandano al client la gestione dello stato.
La specificità di PA Router risiede nella combinazione: classificazione locale, ammissibilità esplicita, supervisione delle CLI agentiche, sessioni strutturate, memoria locale e motore riutilizzabile, il tutto raccolto in un ambiente personale di esecuzione. Non si tratta di un proxy, ma di un layer di governance che sposta le decisioni dalla "testa dell'utente" a policy configurabili e ripetibili.
Stato del progetto e prospettive di rilascio
Non mi interessa descrivere architetture astratte. PA Router è un'applicazione funzionante, con un candidato locale (0.2.0-beta.2) fotografato e sottoposto a stress test.
Tuttavia, il rilascio pubblico avverrà solo quando il meccanismo decisionale e i sistemi di recupero saranno solidi secondo i miei standard. Attualmente, ad esempio, ci sono limiti noti sulla memory injection: i test sul corpus originale mostrano un recupero (recall) insufficiente che deve essere raffinato. Il lavoro ha raggiunto componenti principali stabili e un packaging coerente, ma non sarebbe rigoroso promettere un rilascio imminente finché l'affidabilità semantica non eguaglierà la solidità del routing.
Quello che voglio rendere disponibile non è un altro modo per passare da un modello all'altro, ma uno strumento in cui la scelta dell'LLM sia soltanto l'ultima decisione di una catena di sicurezza che comincia dai dati.